大模型在聊天、写代码、翻译上已经很能打,但把它拉去读一份BIM交付规范、写一段符合IFC语法的XML,表现几乎归零。这不是夸张——日本一家叫ONESTRUCTION的创业公司做了实测:让当前最前沿的通用模型去生成IDS(信息交付规范)文件,XML格式本身写得工工整整,可一查语义,内容一致性得分接近0%。
同一个任务,他们自己训出来的领域模型Ishigaki-IDS,XML结构合规和IDS结构合规都接近100%,内容一致性超过80%。差距不在模型大小,而在训练方法——用合成数据补齐稀缺语料,用可验证奖励让模型"错一次改一次"。这篇文章拆解他们到底怎么做到的。
Ishigaki-IDS:一个只干一件事的基础大模型
ONESTRUCTION是日本一家专攻openBIM的建筑科技创业公司。他们做的Ishigaki-IDS,是一个专精BIM工作流的基础大模型,目标只有一个:生成和校验IDS文件。
IDS(Information Delivery Specifications,信息交付规范)是buildingSMART在2024年发布的标准,用来定义"BIM模型里该附带哪些信息、这些信息怎么校验"。它本质是一套XML,挂在IFC(Industry Foundation Classes)模型之上——业主或甲方用IDS把话说清楚:"我要的模型里,每根梁、每台设备必须填哪些属性",软件和下游再拿它自动核对。
日本建筑业长期缺劳动力,BIM被国家层面力推,因为设计、施工、运维能在一个模型上对齐信息。但IDS有个现实门槛:写它需要懂IFC语法、懂IDS的标签结构,还要会XML。这活过去靠少数专家手写,普通从业者根本插不上手。ONESTRUCTION要做的,就是把这个门槛打下来,让不懂BIM的人也能用自然语言或CSV生成一份合格的IDS。
📌 项目背景速览
- 出品方:ONESTRUCTION, Inc.(日本建筑科技创业公司,openBIM路线)
- 模型:Ishigaki-IDS,专精BIM的IDS生成/校验
- 基座:Qwen3(8B/14B/32B,阿里云开源)
- 背书:日本经济产业省GENIAC(生成式AI加速挑战)第三期入选项目
- 技术顾问:AWS生成式AI创新中心(GenAIIC),双方每两周碰一次
实测数据:通用模型的"会写XML"是假象
他们自建了一套评测基准IDS-Bench,横跨IFC版本、专业(建筑/结构/机电/通用)、语言(日英双语)和Implement/Structure/Content三个维度。结果很扎眼:
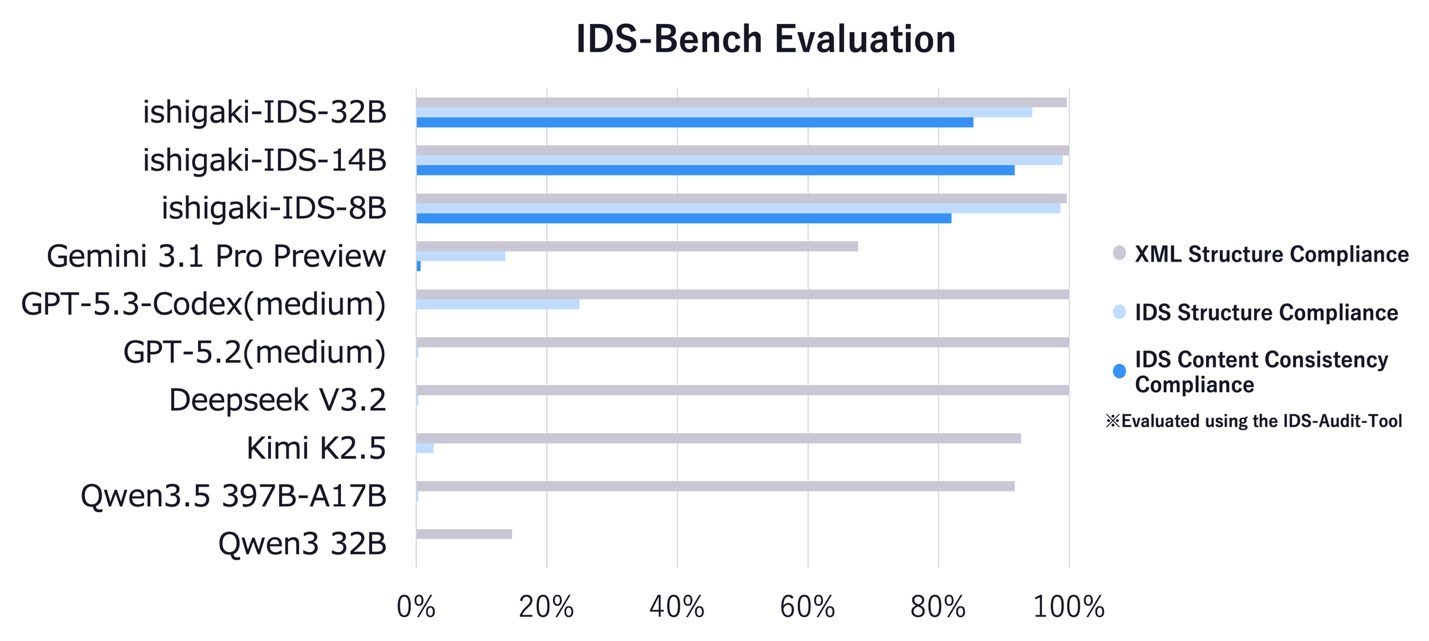
通用模型不是不会写XML——它写出了结构规范的XML,但IDS结构合规不到25%,内容一致性直接跌到0%附近。原因简单:IDS是2024年才发布的新标准,网上公开语料极少,通用模型的训练集里根本没有这东西。它学会的是XML的"形",没学会IDS的"义"。
| 维度 | 通用前沿大模型 | Ishigaki-IDS |
|---|---|---|
| 基座 | 各家旗舰闭源/开源模型 | Qwen3(8B/14B/32B) |
| IDS结构合规 | <25% | ~100% |
| IDS内容一致性 | ~0% | >80% |
| 训练语料 | 互联网通用语料 | IDS/IFC领域语料 + 合成数据 |
| 上下文长度 | 视模型而定 | YaRN扩展至约120k tokens |
三阶段训练:为什么小模型能赢大模型
他们的做法是一条三段式训练管道,模型从Qwen3起步,先在8B/14B上试,最后上32B。
🔄 三阶段训练管道
第三步是整个方案的点睛之笔。RLVR特别适合IDS,因为它不靠海量人工标注,只用"客观对错信号"就能把输出质量磨上去——这对数据稀缺的领域尤其重要。而RLVR能跑通的前提,是存在一个客观的校验工具。IDS恰好有IDS-Audit-Tool,这成了小模型也能出效果的底气。
基础设施方面,训练用了两台Amazon EC2 P5en实例(每台p5en.48xlarge,NVIDIA H200 GPU),AWS ParallelCluster做集群编排,FSx for Lustre做共享存储,跑的是稳定的多节点分布式训练。
他们在总结里给了三条经验,值得国内做行业大模型的团队照着掂量:合成数据质量比数量重要(领域专家的参与是决定性因素);可验证奖励能大幅加速迭代(自动打分比人工评估快得多);稳定基础设施让人敢试(不用天天跟集群故障搏斗,精力能回到模型上)。
这件事对BIM工程师意味着什么
Ishigaki-IDS不是孤例,它指向的是一个正在发生的方向:工地的AI不会是"一个大模型通吃",而是"通用模型打底 + 领域小模型干活"。而领域小模型能不能训出来,取决于两样东西——有没有结构化数据,有没有客观校验标准。
💡 对BIM工程师的启示
1. 现在就去学IDS。IDS是openBIM的下一件大事,国内对应的"模型信息交付深度 / 分类编码"正在铺开。谁先把IDS、IFC、分类编码吃透,谁就提前占了信息交付的卡位——这比再学一个新建模软件值钱。
2. 把模型整理成机器能用的数据,是下一阶段的核心能力。Ishigaki-IDS能训出来,靠的是专家把IFC那几千个术语映射(beam→IfcBeam、空调→IfcUnitaryEquipment)和IDS语法喂给模型。谁能把BIM模型、设计规范、验收标准整理成结构化数据,谁就是AI时代最抢手的人。
3. 模型已开源,可以拿来试。Ishigaki-IDS-8B已经放在Hugging Face上,BIM工程师完全可以用自己的IDS场景去跑一跑,直观感受"领域模型"和"通用模型"在工程数据上的差距有多大。
一句话收尾:这个案例的真正价值,不在于某个日本创业公司训了个模型,而在于它用一条可复制的方法证明了——在数据稀缺、语义严格的工程领域,通用大模型不是终点,领域专用模型才是。对正处在"要不要上AI"十字路口的BIM从业者来说,这比任何发布会都更有参考意义。
参考资料
AWS Machine Learning Blog《How ONESTRUCTION built the Ishigaki-IDS foundation model with AWS GenAIIC》(2026-08-11);buildingSMART openBIM/IDS标准文档;Ishigaki-IDS Hugging Face模型页。